チーム向けプライベートAI:自社データをモデルの学習に使わせない
プライベートAIとは、自社の文書がモデルの学習から切り離され、暗号化され、アクセスを許可した人だけが閲覧できる仕組みを指します。選定にあたっては次の3点を確認してください。モデル提供事業者とのゼロデータ保持、暗号化と個人単位のアクセス制御、そして不透明なWebデータではなく自社ファイルに基づいた回答であること。Tatsulokは、すべてのチャットリクエストをゼロデータ保持のモデル提供事業者にだけ送り、ファイルを保存時に暗号化し、アクセスを人ごとに設定できます。
更新日
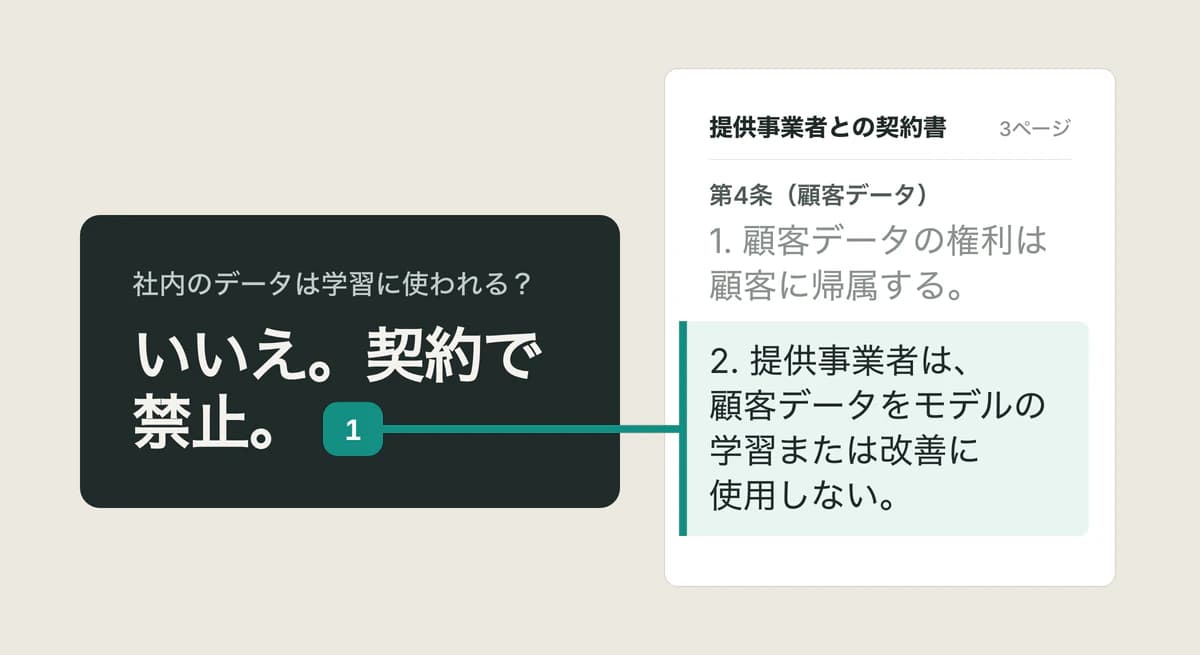
AIはあなたのデータを学習しますか?
ツールによって異なります。多くの一般向けAI製品では、オプトアウトしない限り、入力したプロンプトやアップロードしたファイルが保持され、将来のモデルの改善や学習に使われる場合があります。リスクは、契約書・顧客記録・社内戦略といった機密情報が、自分が管理できないモデルに取り込まれ、別の場所で表に出てしまうことです。
安全な姿勢は、モデル提供事業者とのゼロデータ保持です。プロバイダーはリクエストを処理して回答を返すだけで、学習用に何も残しません。Tatsulokはチャットのリクエストをゼロデータ保持のモデル提供事業者にだけ送るため、質問も、一緒に送られる文書の内容も、それらの事業者に保持されず、学習にも使われません。音声入力、Web検索、文書の抽出、検索結果の並べ替えは、それぞれの提供事業者の規約のもとで動き、プライバシーポリシーに明記しています。
プライバシーへの懸念は広く、根拠のあるものです。Cyberhavenの職場におけるAI利用の分析では、従業員がChatGPTに貼り付ける内容のおよそ11%が会社の機密データでした。これはまさに、アクセス管理されたプライベートなワークスペースが防ぐべき情報漏えいです。
AIツールを「プライベート」たらしめるものは何ですか?
プライバシーは標語ではなく仕組みです。真にプライベートなAIツールは、具体的に次の3つを満たします。第一に、あなたのコンテンツが決してモデルの学習に使われないことを保証します。第二に、データを通信時・保存時ともに暗号化し、共有や公開ではなく初期状態で非公開に保ちます。第三に、実質的な制御を与えます。各文書を誰が閲覧できるかをチーム単位・個人単位で決められ、いつでもコンテンツを削除できます。
これらを平易な言葉で説明できないツールは、プライバシーの主張が未検証だと考えてください。
チームは共有文書の機密性をどう保ちますか?
チーム内の機密性は、アクセス制御の問題です。答えは共有をやめることではなく、正確に共有することです。各文書には、特定のチームまたは特定の個人へ明示的にアクセス権を付与し、必要な人だけが閲覧できる状態にすべきです。
誰かがプロジェクトを離れたり業務が終わったりした際には、アクセス権を取り消し、不要になったコンテンツを削除します。Tatsulokではアクセスをチーム単位・個人単位で制御できます。
チームの知識は、人が去っても残りますか?
機密の知識は、それを作った人よりも長く残るべきです。回答が個人の非公開チャット履歴に存在すると、その人が去るときに知識も一緒に出て行き、取り消す手段もありません。
プライベートなチーム ライブラリはこれを解決します。文書が散らばったプロンプトではなく、一元的にアクセス管理された場所に存在するため、組織の知識は蓄積し続け、去る人のアクセスを取り消してもチームが築いたものは失われません。継続性と管理は同じ仕組みです。
Tatsulokはどのようにデータを保護しますか?
Tatsulokは初期状態でデータを非公開に保ち、ワークスペースの内容を学習用データセットに送ることはありません。ファイルは保存時に暗号化され、誰がアクセスできるかをチーム単位・個人単位で制御でき、いつでも任意のコンテンツを削除できます。
同じく重要な点として、ファイルについての回答は自社の文書に基づき、各回答は出典の該当箇所に正確に引用が付き、ハイライト付きプレビューと原文へのリンクが添えられるため、どの記述がどこから来たのかを検証できます。TatsulokはPDF、Word、Excel、PowerPointのファイルを読み、英語と日本語に対応しています。
FAQ
- Tatsulokは私の文書をAIモデルの学習に使いますか?
- いいえ。チャットのリクエストは、ゼロデータ保持のモデル提供事業者にだけ送られます。これらの事業者は、学習に使わず、回答後に内容を保持しないことを約束しています。音声入力、Web検索、文書の抽出、検索結果の並べ替えは、それぞれの提供事業者の規約のもとで動き、プライバシーポリシーに明記しています。
- 私のデータは暗号化されますか?
- はい。ファイルとワークスペースのデータベースは保存時にAES-256で暗号化され、通信はHTTPSで保護され、共有や公開ではなく初期状態で非公開に保たれます。
- アップロードした文書は誰が閲覧できますか?
- アクセスを許可した人だけです。アクセスをチーム単位・個人単位で制御できるため、各文書はあなたが選んだ相手だけに表示されます。
- 誰かがチームを去ると、チームの知識はどうなりますか?
- 残ります。知識は個人のチャット履歴ではなく、アクセス管理されたチームの共有ライブラリに存在するため、アクセス権を付与した全員が引き続き利用できます。去る人のアクセスを取り消しつつ、組織の知識は蓄積し続けます。
- コンテンツは削除できますか。本当に消えますか?
- はい。削除したアイテムはゴミ箱に移り、少なくとも30日後に、保存されたコピーや検索インデックスとともに削除されます。「完全に削除」を使えばすぐに削除されます。
- AIの回答はどこから来るのですか?
- ファイルについての回答は、自社でアップロードした文書に基づきます。各回答は出典の該当箇所に正確に引用が付き、ハイライト付きプレビューと原文へのリンクで検証できます。
出典
関連ガイド
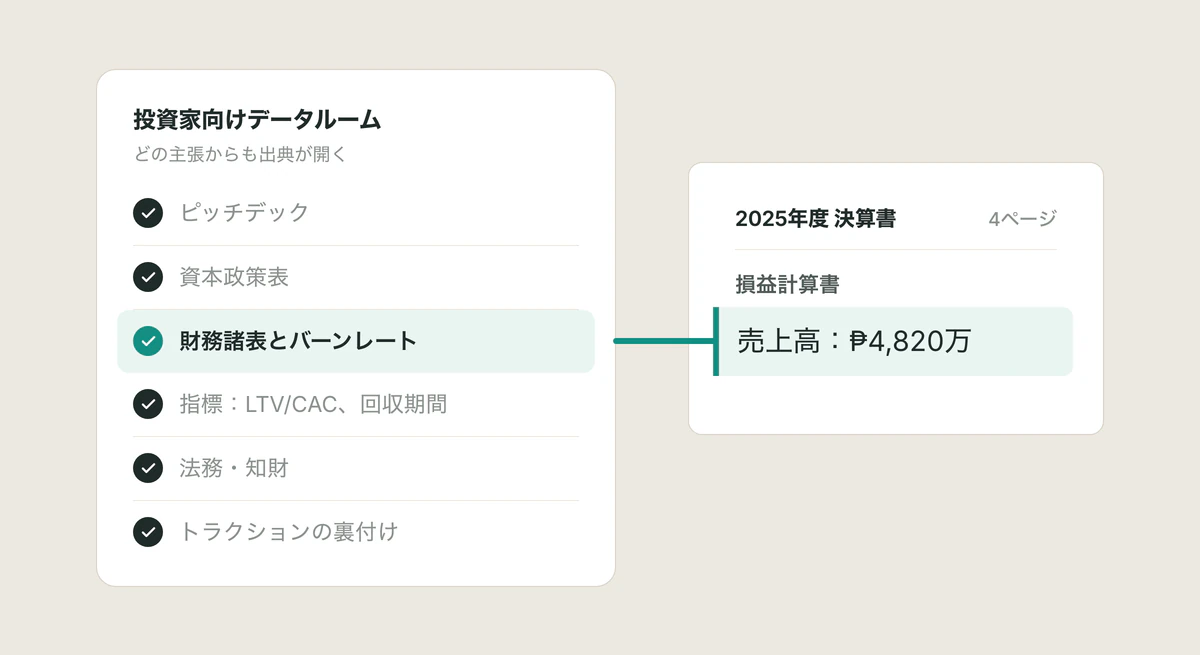
データルーム チェックリスト
資金調達用のスタートアップのデータルームには、ピッチデック、資本政策表、財務、法務、トラクションの証拠を、投資家がすべての主張を検証できる形で整理して含めるべきです。完全なチェックリストを紹介します。
記事を読む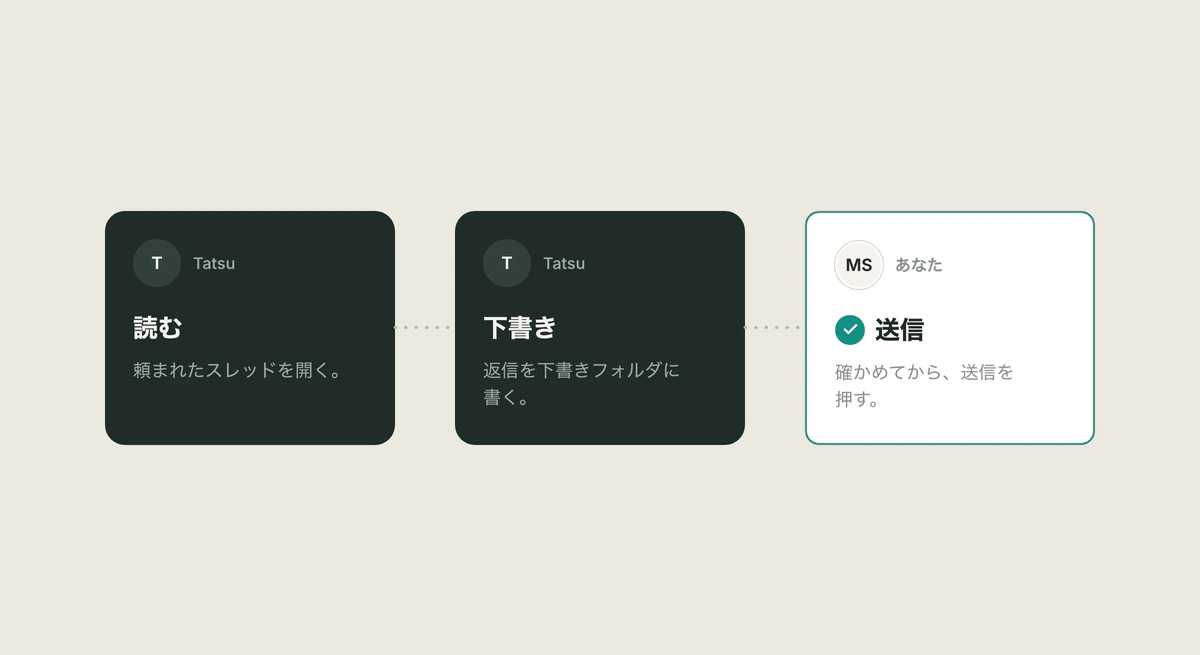
メールへの安全なアクセス
読む、下書き、送信は、別々の3つの権限です。Gmail や Outlook でそれぞれがアシスタントに何を許すのか、送信を自分の手に残すべき理由、Google の未確認アプリの画面の意味、アクセスを取り消す方法をまとめます。
記事を読む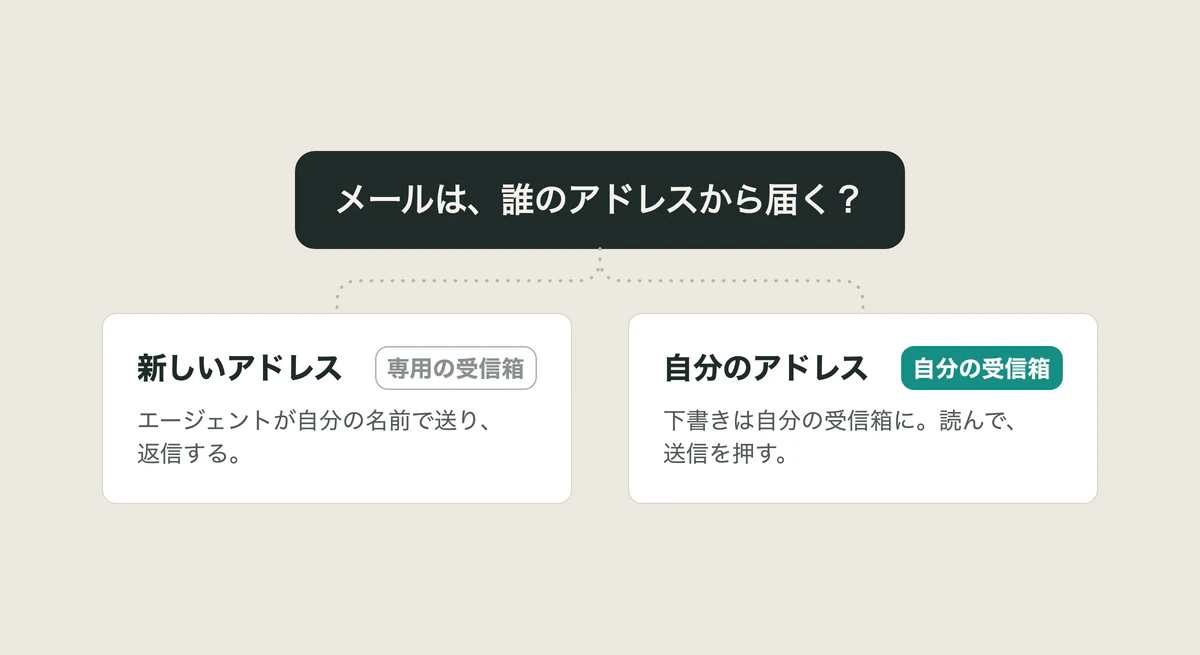
AI エージェントのメール
エージェントが自分の名前でメールを送受信するなら、専用の受信箱を用意します。自分のメールで手伝ってほしいなら、あなたのメールボックスに下書きを作り、送信はあなたに任せるツールを選びます。MCP サーバーの位置づけも、2026年10月14日時点で確認しました。
記事を読む