トピック
実務におけるRAG(検索拡張生成)
RAG(検索拡張生成)は、自社の資料から関連箇所を検索し、質問と併せてモデルに渡します。これにより回答は、モデルが学習時に取り込んだ内容ではなく、自社の文書に根拠づけられます。本シリーズでは、その処理の流れと他手法との使い分けを扱います。
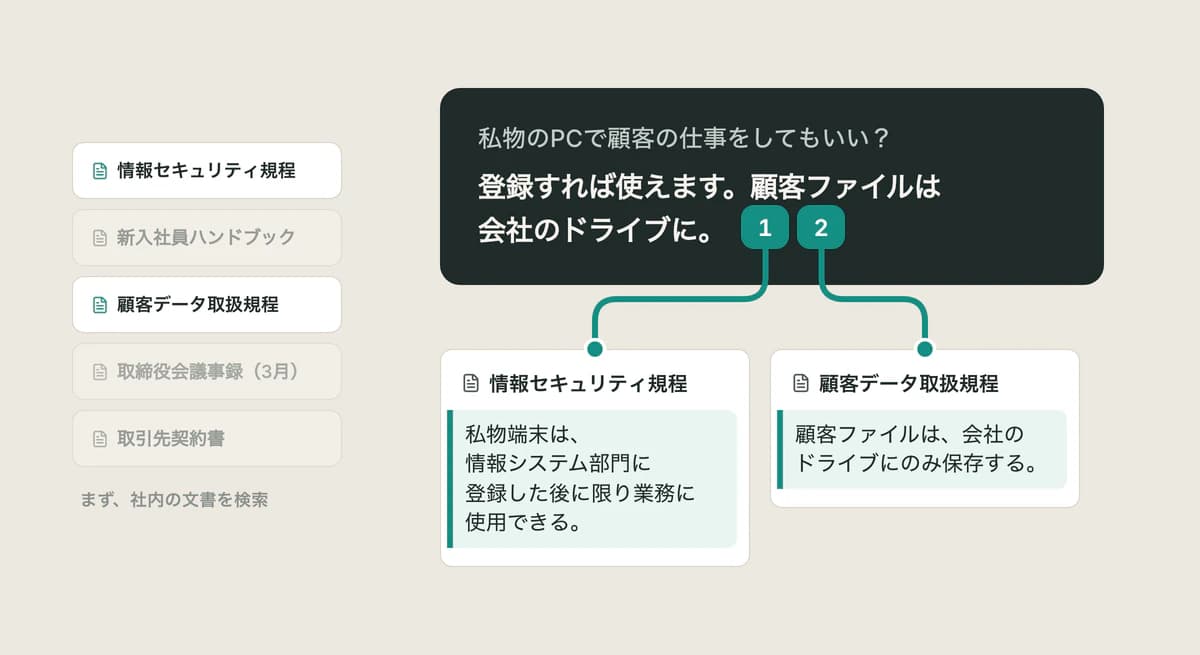
社内RAGガイド
RAG(検索拡張生成)とは、社内文書をAIに検索させ、出典付きで回答を得る仕組みです。社内規程・社内データの検索を出典・検証付きで実現する、社内RAG導入の基礎から進め方までを解説します。
記事を読む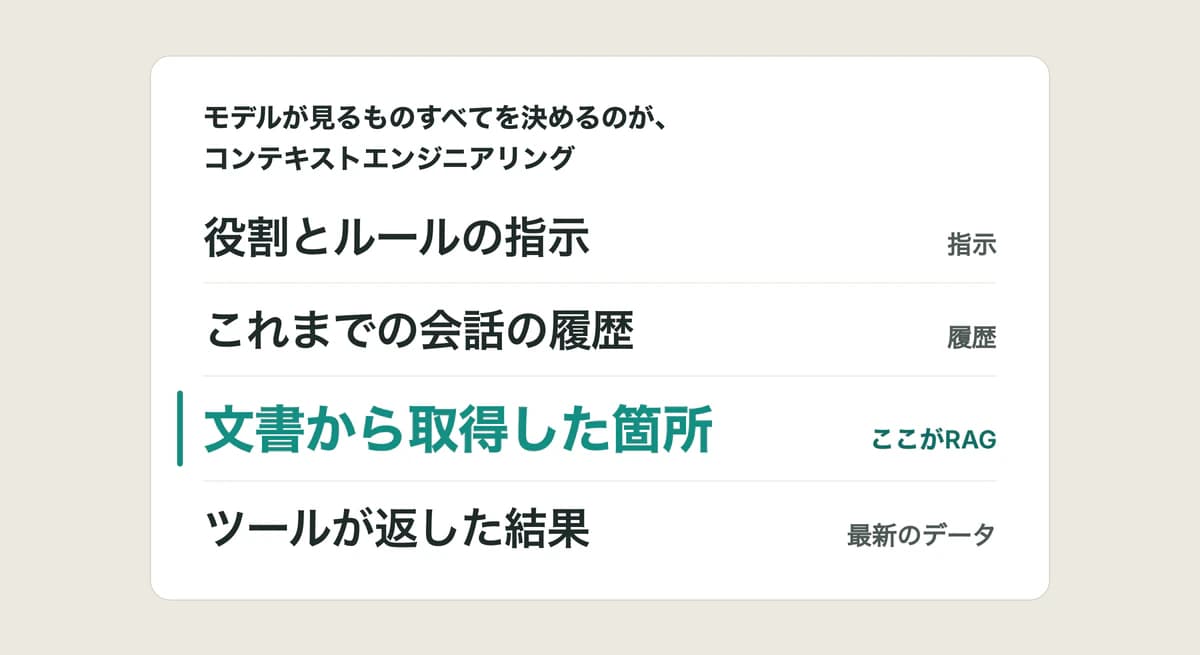
コンテキストエンジニアリングとRAG
コンテキストエンジニアリングは、回答時にAIが見るすべてを整える実践であり、RAGはその中の一手法です。両者の関係と、それぞれが重要になる場面を解説します。
記事を読む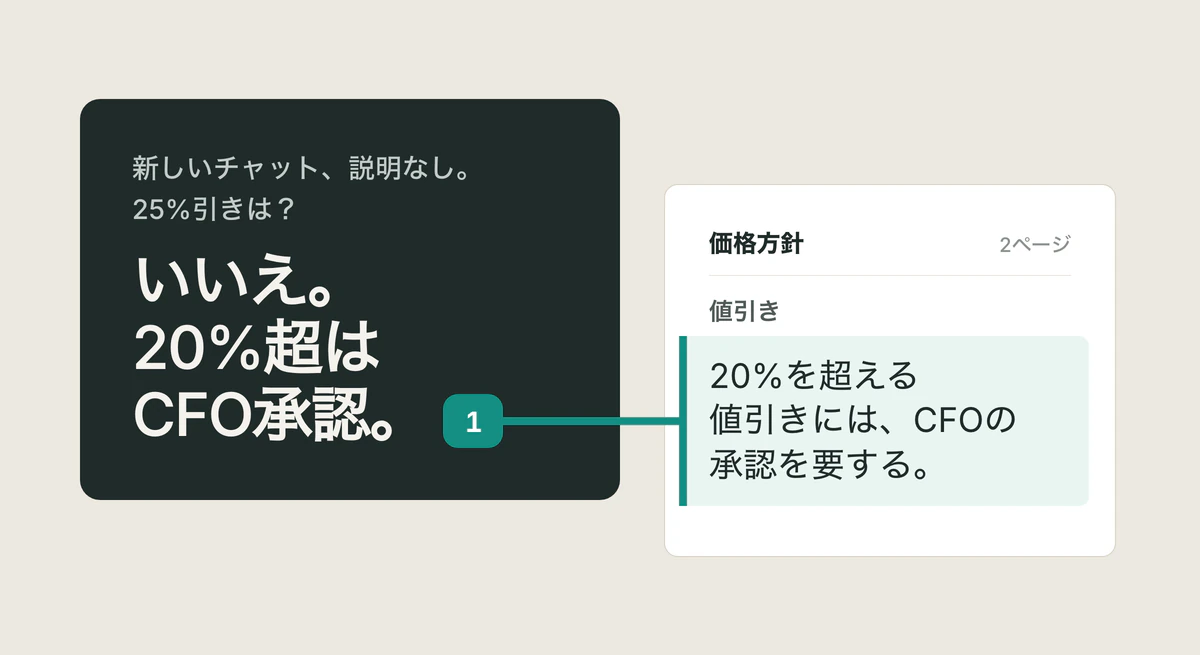
AIに適切なコンテキストを与える
新しいチャットは毎回白紙から始まるので、同じ背景を貼り付け直すことになります。文書を一箇所に置き、一度だけ尋ね、答えの行を開いてください。
記事を読む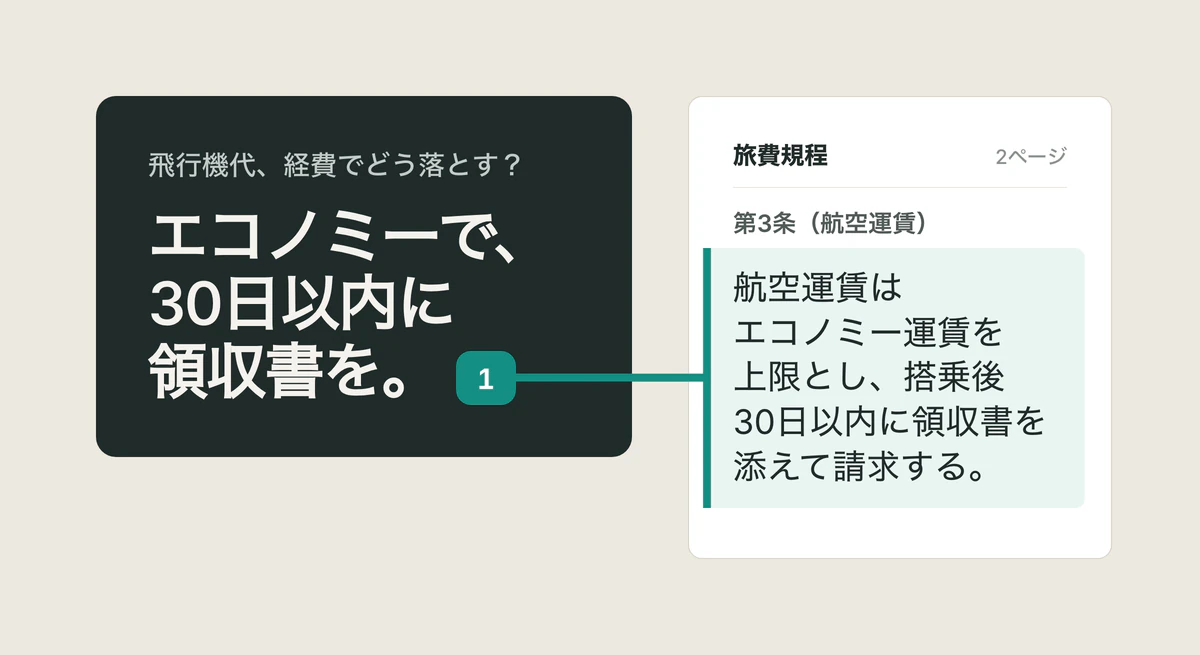
AIナレッジベース
AIナレッジベースは、セマンティック検索とRAGを使い、あなたの文書を出典付きの平易な回答に変えます。その仕組みと、信頼できるナレッジベースの条件を解説します。
記事を読む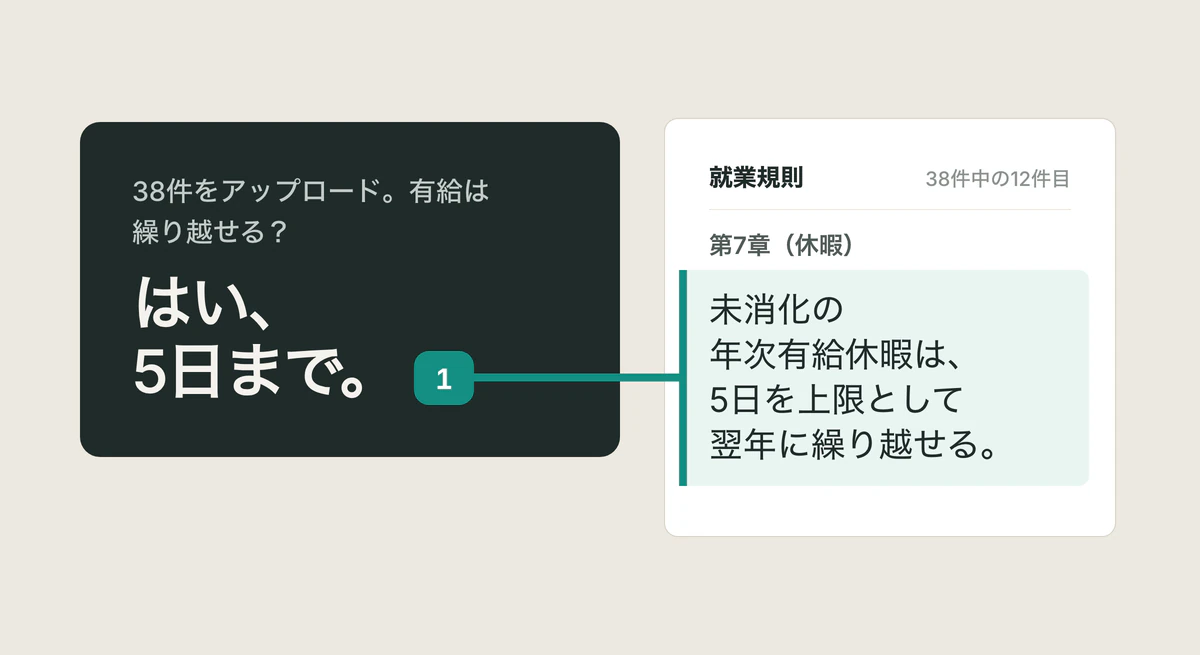
文書からナレッジベースへ
文書のフォルダをAIナレッジベースに変える手順を解説します。集める、アップロードする、尋ねる、検証する。タグ付けもスキーマもコードも不要です。
記事を読む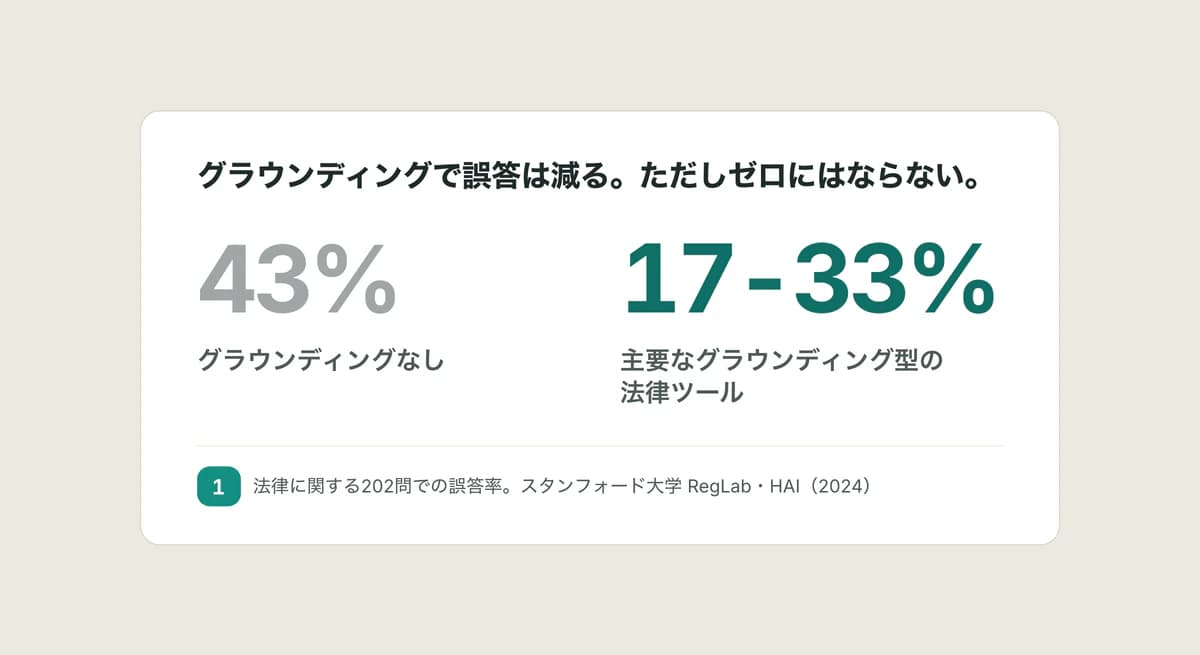
RAGのハルシネーション率
RAG(検索拡張生成)はAIのハルシネーションを大幅に減らしますが、ゼロにはしません。スタンフォード大学の測定では主要リーガルRAGツールで17〜33%、GPT-4単体で43%。実数と残存リスクへの設計を解説します。
記事を読む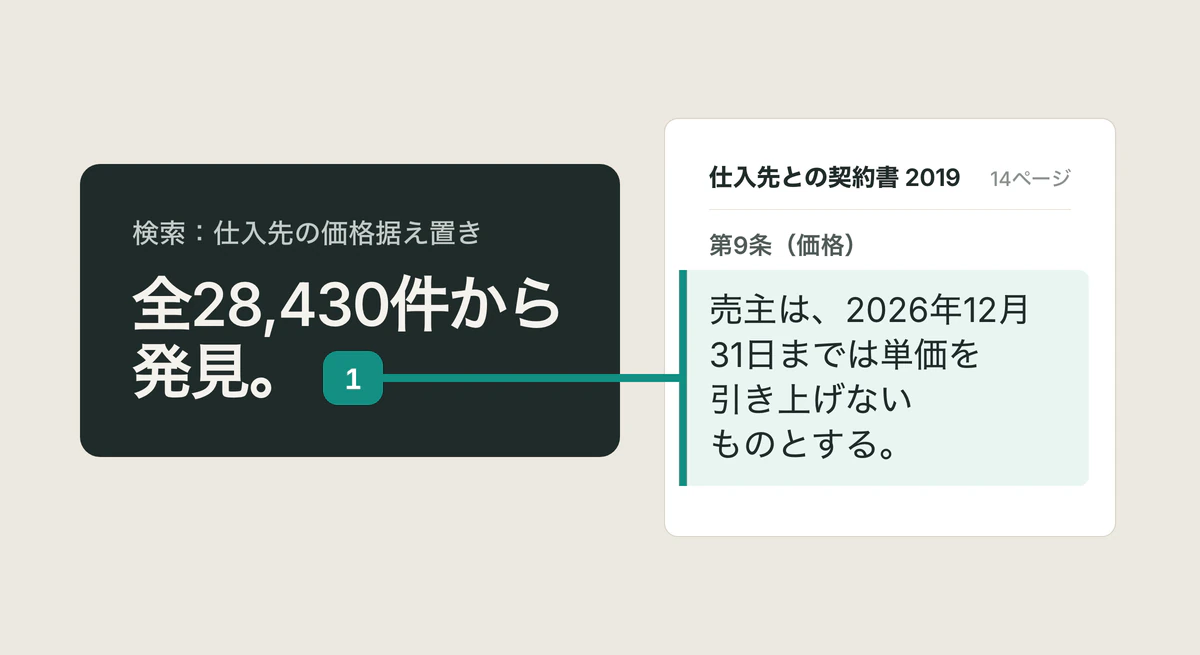
大きなライブラリでの検索
大きなライブラリでは、一部のアカウントで検索がいつも失敗していました。今はライブラリをページごとに読み、上限に達したらどこで止まったかを記録します。何が壊れていたか、何が変わったか、何がまだ上限付きなのかを説明します。
記事を読む